Schweden

Luxemburg

Deutschland
Frankreich

Niederlande
Niederlande

Frankreich
Frankreich

Italien
Irland

[
KONTINENT COMPUTE CLOUD
]
Trainieren, hosten, kontinuierlich verbessern: auf EU-Infrastruktur, mit unseren Researchern an der Seite Ihres Teams.
[
TRAINING
]
Souveräne Infrastruktur für schnellere, bessere und günstigere KI-Modelle.
Post-Training für Ihre Aufgabe, nicht für den Durchschnitt.
Distillation, Fine-Tuning und RL auf Ihren Daten, in Ihrem Harness und mit Gradern, die Ihre Fachleute definieren. Die Methode folgt der Aufgabe, nicht umgekehrt.
Optimieren Sie auf Ihre Evals, nicht auf Benchmarks.
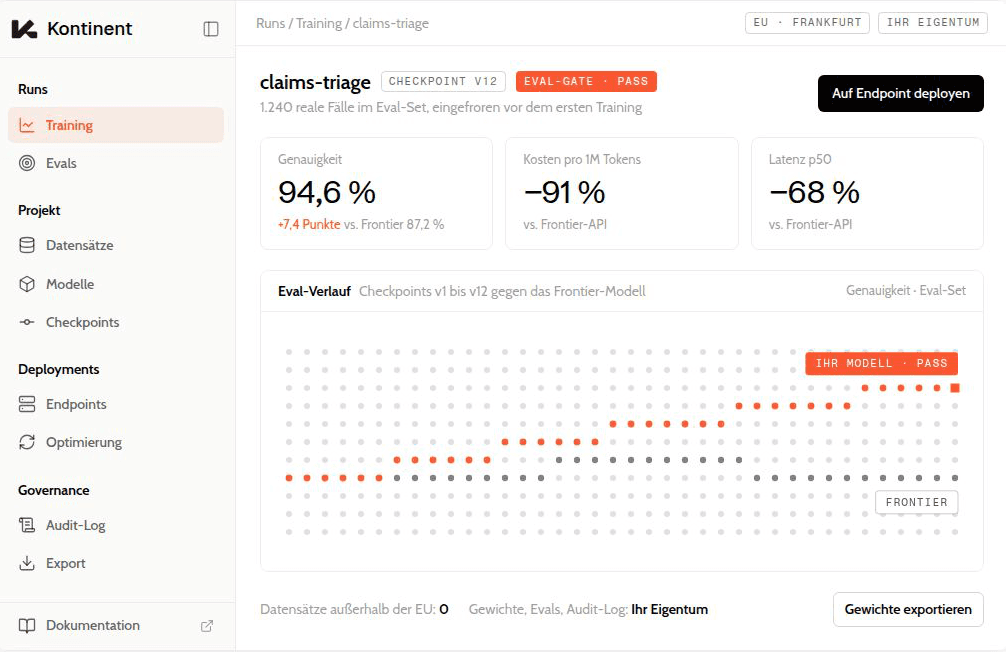
Das Eval-Set entsteht aus Ihren echten Fällen und wird eingefroren, bevor das erste Training startet. Rewards kalibrieren Sie auf die KPIs Ihres Produkts, und pro Checkpoint sehen Sie, was das Modell gelernt hat.
Bleiben Sie beim Basismodell flexibel.
Sie starten auf dem besten offenen Modell von heute und wechseln auf das nächste, sobald es erscheint. Eval-Set, Datenpipeline und Endpoint bleiben gleich, und ausgerollt wird nur, was die Baseline schlägt.
[
INFERENZ
]
Flexible, produktionsreife Inferenz auf dedizierten GPUs in der EU.
Serving in der Umgebung, in der Sie trainiert haben.
Checkpoint, Tokenizer und Prompt-Format gehen unverändert vom Training auf den Endpoint. Was Sie evaluiert haben, ist exakt das, was in Produktion läuft.
Ausgelegt auf Ihren Workload, betrieben unter EU-Recht.
Von asynchronen Batch-Jobs bis zu Echtzeit-Anwendungen: Durchsatz, Latenz und Parallelität legen Sie pro Deployment fest. Dedizierte GPUs in EU-Rechenzentren, ohne US-Hyperscaler in der Kette.
Vom Checkpoint auf den Endpoint, ohne Umweg.
Jeder Checkpoint, der das Eval-Gate passiert, geht direkt auf Ihren Endpoint, mit Audit-Trail für jeden Schritt. Die API ist OpenAI-kompatibel: Ihre Anwendungen tauschen nur Endpoint und Key.
[
OPTIMIERUNG
]
Modelle die besser werden je mehr sie benutzt werden.
Machen Sie echte Nutzung zu Trainingsdaten.
Traces, Korrekturen und Reviewer-Feedback vom Endpoint werden zu Beispielen und Reward-Signalen für den nächsten Trainingslauf. Das Modell lernt aus den Fällen, die Ihnen wirklich begegnen.
Retraining hinter einem festen Eval-Gate.
Jede neue Version muss das aktuelle Modell auf demselben Eval-Set schlagen, sonst geht sie nicht live. Sie sehen pro Version, was dazugelernt wurde und wo es noch fehlt.
Rollouts mit A/B-Test, Monitoring und Rollback.
Release-Kandidaten laufen gegen die aktuelle Version, bevor sie den ganzen Traffic bekommen. Genauigkeit, Kosten und Latenz sehen Sie pro Version, ein Rollback ist jederzeit möglich.
[
ZUSAMMENARBEIT
]
Zwei Modelle der Zusammenarbeit, je nachdem, wie viel Sie selbst in der Hand behalten wollen. Die Infrastruktur darunter ist dieselbe.
Embedded
Wir sitzen mit Ihren Engineers am Tisch: vom gemeinsamen Design des ersten Evals bis zum Deployment des Modells und darüber hinaus.
Managed
Ihr Team entwirft und fährt die Experimente. Wir kümmern uns um Training, Serving und Infrastruktur.
[
SOUVERÄNITÄT
]
Gebaut für Kunden mit den höchsten Ansprüchen an Souveränität, Sicherheit und Geschwindigkeit.
DSGVO
EU AI ACT
DORA
Daten verlassen die EU nicht.
Training und Inferenz laufen auf dedizierten GPUs in EU-Rechenzentren unter EU-Recht. Kein US-Hyperscaler in der Kette, AVV vor dem ersten Datensatz.
Jede Entscheidung nachvollziehbar, bis zum Trainingslauf.
Versionierte Daten, Evals und Checkpoints, Audit-Logs für jeden Schritt, zugeordnet zu den Pflichten aus EU AI Act und DORA. Die Dokumentation entsteht im Prozess, nicht danach.
Sie besitzen die Intelligenz.
Weights, Eval-Set und Dokumentation gehören Ihnen. Sie entscheiden, was trainiert und was ausgerollt wird, und nehmen das Modell jederzeit mit, auf Ihre eigene Infrastruktur, wenn Sie wollen.